

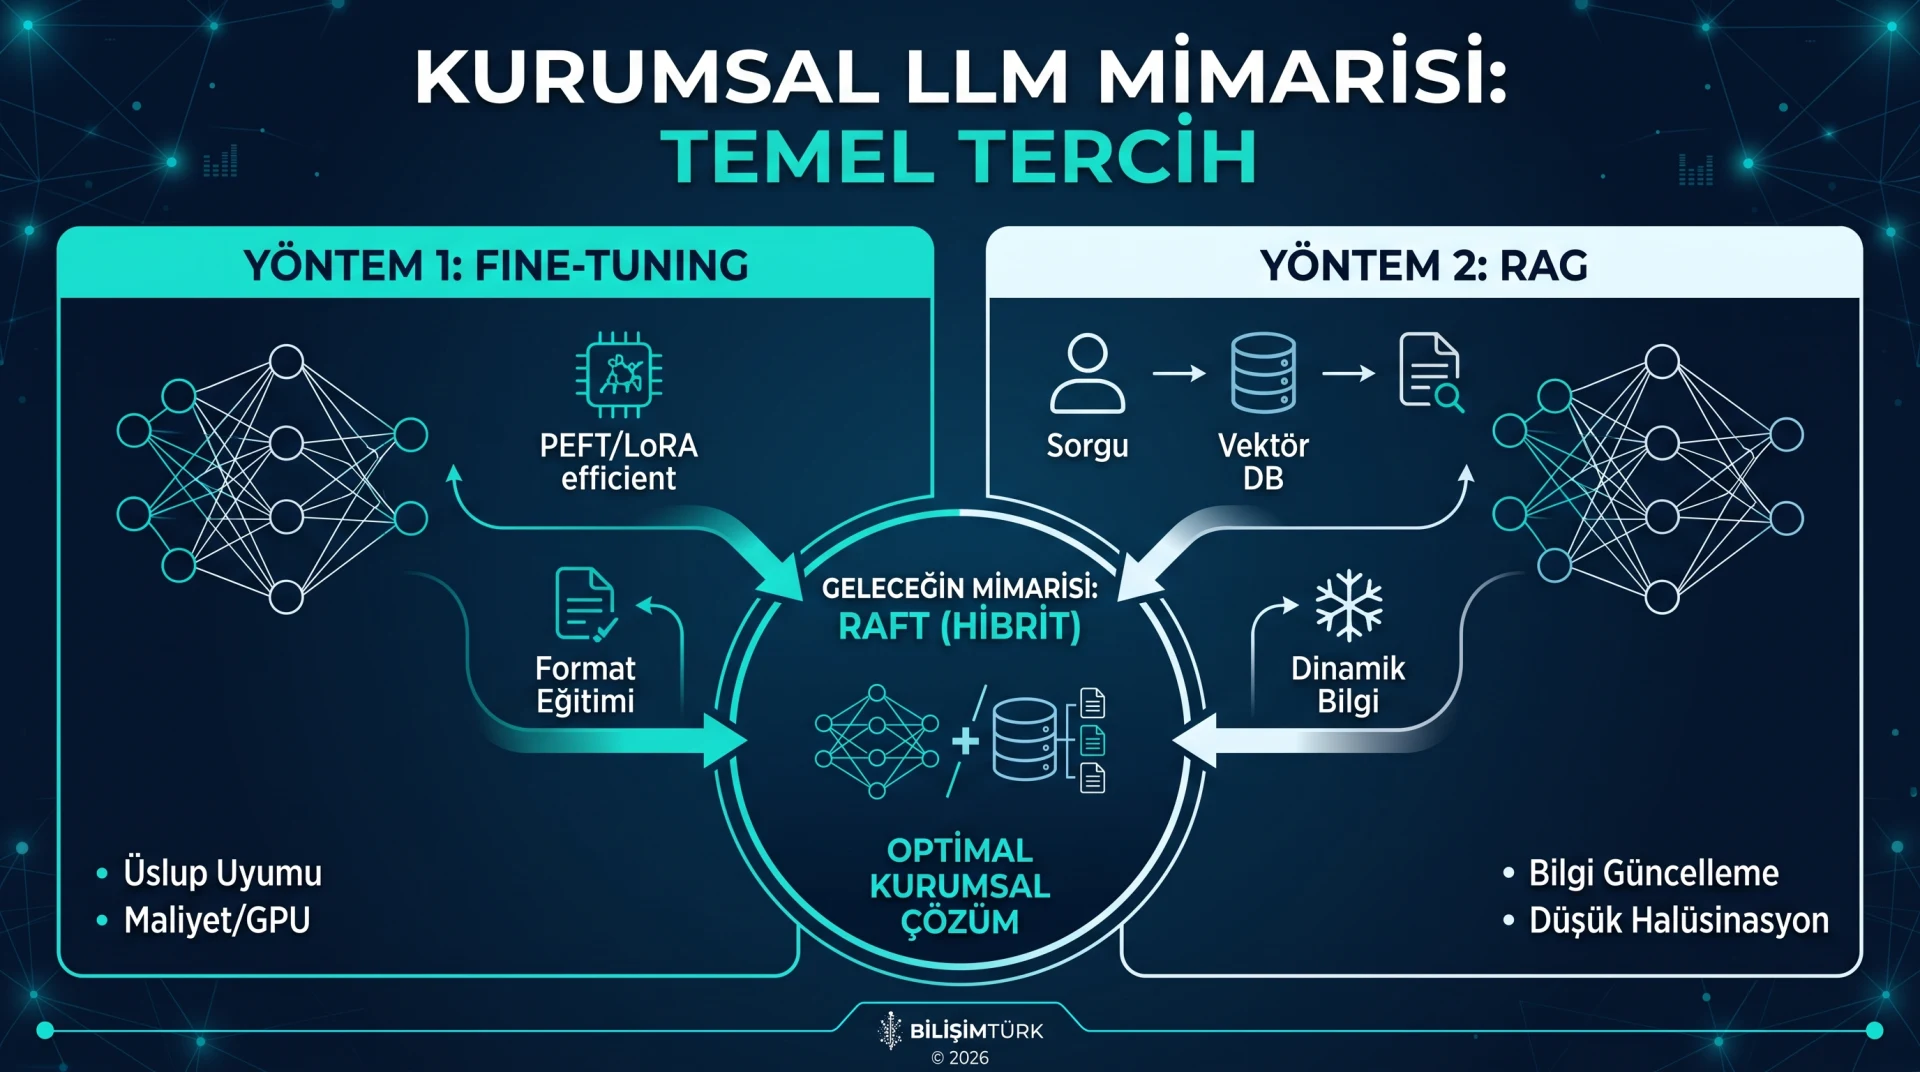
Kurumsal LLM Entegrasyonunda Mimari Çıkmaz: İnce Ayar (Fine-Tuning) mı, Getirme Destekli Üretim (RAG) mi?
Geniş Dil Modelleri (LLM), kurumsal yazılım mimarilerinin merkezine yerleşirken mühendislik ekiplerinin karşısına kritik bir sistem tasarım tercihi çıkmaktadır: Modeli kuruma özel verilerle yeniden eğitip ince ayar (Fine-Tuning) mı yapmalıyız, yoksa dinamik bir bilgi alma katmanıyla RAG (Retrieval-Augmented Generation) mimarisi mi kurmalıyız?
Bu makalede her iki yaklaşım; bilgi tazeliği, halüsinasyon denetimi, veri güvenliği (RBAC) ve toplam sahip olma maliyeti (TCO) parametreleri üzerinden derinlemesine analiz edilmektedir.
1. Parametrik Hafıza ve Bağlamsal Bilgi Ayrımı
Bir dil modelinin mimarisini doğru ölçeklemek, verinin nerede depolandığını anlamakla başlar:
- Parametrik Bilgi (Fine-Tuning / Ağırlıklar): Modelin eğitim aşamasında sinir ağı ağırlıklarına (weights) gömülen bilgidir. Statiktir. Güncellenmesi için yeniden eğitim veya parametre-verimli ince ayar (PEFT / LoRA) döngüsü gerektirir.
- Bağlamsal / Non-Parametrik Bilgi (RAG): Modelin ağırlıklarına müdahale etmeden, çıkarım (inference) anında modelin girdi penceresine (prompt context window) harici bir vektör veritabanından dinamik olarak aktarılan bilgidir.
2. Metrik Bazlı Mimari Karşılaştırma
Sistem mimarlarının seçim yaparken değerlendirmesi gereken temel mühendislik metrikleri aşağıdaki tabloda özetlenmiştir:
| Parametre | Retrieval-Augmented Generation (RAG) | Parameter-Efficient Fine-Tuning (PEFT/LoRA) |
|---|---|---|
| Bilgi Güncelliği | Anlık (Real-Time): Vektör dizinine yeni veri eklendiği saniyede yanıt güncellenir. | Gecikmeli: Bilginin modele girmesi için eğitim döngüsünün yeniden çalıştırılması gerekir. |
| Halüsinasyon Riski | Düşük: Model, prompt içindeki referans parçaya (ground truth) sıkı şekilde kısıtlanabilir. | Orta-Yüksek: Model ağırlıklarındaki örtük bilgi zaman zaman hatalı genellemeler yapabilir. |
| Kaynak Atfı (Citation) | Doğal Destek: Çıkarılan metin parçası ve kaynak URL doğrudan yanıta iliştirilir. | Mümkün Değil: Yanıtın hangi spesifik model nöronundan tetiklendiği doğrulanamaz. |
| Rol ve Yetki (RBAC) | Kolay: Veritabanı aşamasında kullanıcı token'ına göre meta-veri filtrelemesi yapılır. | İmkânsız: Model tek ağırlık setine sahiptir; yetkisiz personele veri sızma riski vardır. |
| Üslup ve Jargon Uyumu | Sınırlı: Yalnızca Few-Shot Prompting sınırları dahilinde yönlendirilebilir. | Mükemmel: Kurumun üslubu, teknik jargonu veya kod formatı doğrudan ağırlıklara işlenir. |
| Altyapı Maliyeti | Ölçeklenebilir: Düşük GPU gereksinimi; temel maliyet vektör DB ve orkestrasyondur. | Yüksek: Eğitim sürecinde yüksek VRAM'li ayrılmış GPU altyapısı gerektirir. |
3. Ne Zaman Hangi Yaklaşım Tercih Edilmeli?
Senaryo A: RAG Mimarisinin Zorunlu Olduğu Durumlar
Aşağıdaki senaryolarda RAG altyapısı endüstri standardı olarak kabul edilir:
- Sürekli Güncellenen Veriler: Fiyat listeleri, yasal yönetmelikler, iç politika ve şirket içi süreç dokümanları.
- Katı Veri İzolasyonu (Multi-Tenancy): Her departmanın (ör. İK ve Finans) yalnızca kendi yetki alanındaki belgeleri sorgulaması gerektiği durumlar.
- Denetlenebilirlik Zorunluluğu: Finans ve sağlık sektörlerinde üretilen her çıktının kesin bir referans kaynağına dayanması zorunludur.
Senaryo B: Fine-Tuning Mimarisinin Üstün Olduğu Durumlar
- Yapılandırılmış Çıktı Üretimi: Modelin katı JSON şemalarına veya kurumun özel bir programlama framework'üne göre hatasız kod üretmesi istendiğinde.
- Uç Birimlerde Dağıtım (Model Distillation): 70B boyutundaki genel bir modelin yeteneklerini, 7B veya 8B parametreli yerel bir modele indirgeyerek düşük kaynaklı sunucularda çalıştırmak gerektiğinde.
Kaynakça ve Akademik Referanslar
- Lewis, P., et al. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. Advances in Neural Information Processing Systems (NeurIPS). arXiv:2005.11401
- Hu, E. J., et al. (2021). LoRA: Low-Rank Adaptation of Large Language Models. International Conference on Learning Representations (ICLR). arXiv:2106.09685
- Zhang, T., et al. (2024). RAFT: Adapting Language Models to Retrieval Augmented Generation Tasks. UC Berkeley AI Research. arXiv:2403.10131
- Google Cloud Architecture Center (2024). Enterprise Generative AI Design Patterns and Retrieval-Augmented Architectures.
Yorumlar
Henüz yorum yapılmamış. İlk yorumu siz yapın!